Research & Development
L’IA trouve la cible plus vite que vous, mais elle ne cherche pas comme vous
Chercheur scientifique chez F-Initiatives, AIOps Architect chez NeoPhi, Dr en informatique
Sur cette page
Mohamed Amine Kerkouri est chercheur scientifique chez F-Initiatives et AIOps Architect chez NeoPhi, où il conçoit et opérationnalise des agents d’IA dédiés à l’exploration de la littérature scientifique, avec un accent particulier sur la mise en place de workflows fiables pour retrouver, analyser et synthétiser les connaissances scientifiques.
Il est titulaire d’un doctorat en informatique de l’Université d’Orléans, où il a développé des modèles de deep learning appliqués à l’attention visuelle humaine dans les peintures et créé AVAtt, un jeu de données de suivi du regard consacré à l’art. Ses recherches portent sur l’eye tracking, l’analyse des scanpaths et l’IA multimodale. En particulier, ses travaux sur la manière dont les modèles d’IA traitent et combinent les informations visuelles et textuelles sont étroitement liés aux ambitions de NeoPhi, puisque la compréhension des publications scientifiques doit de plus en plus aller au-delà du seul texte pour intégrer également les figures, les schémas et d’autres contenus scientifiques visuels.
Ses travaux récents sur les méthodes de comparaison de scanpaths ont été présentés à ETRA 2026, et l’article présenté dans cette publication a reçu le Outstanding Paper Award lors du workshop Human-Inspired Vision d’ECCV 2026.
Introduction
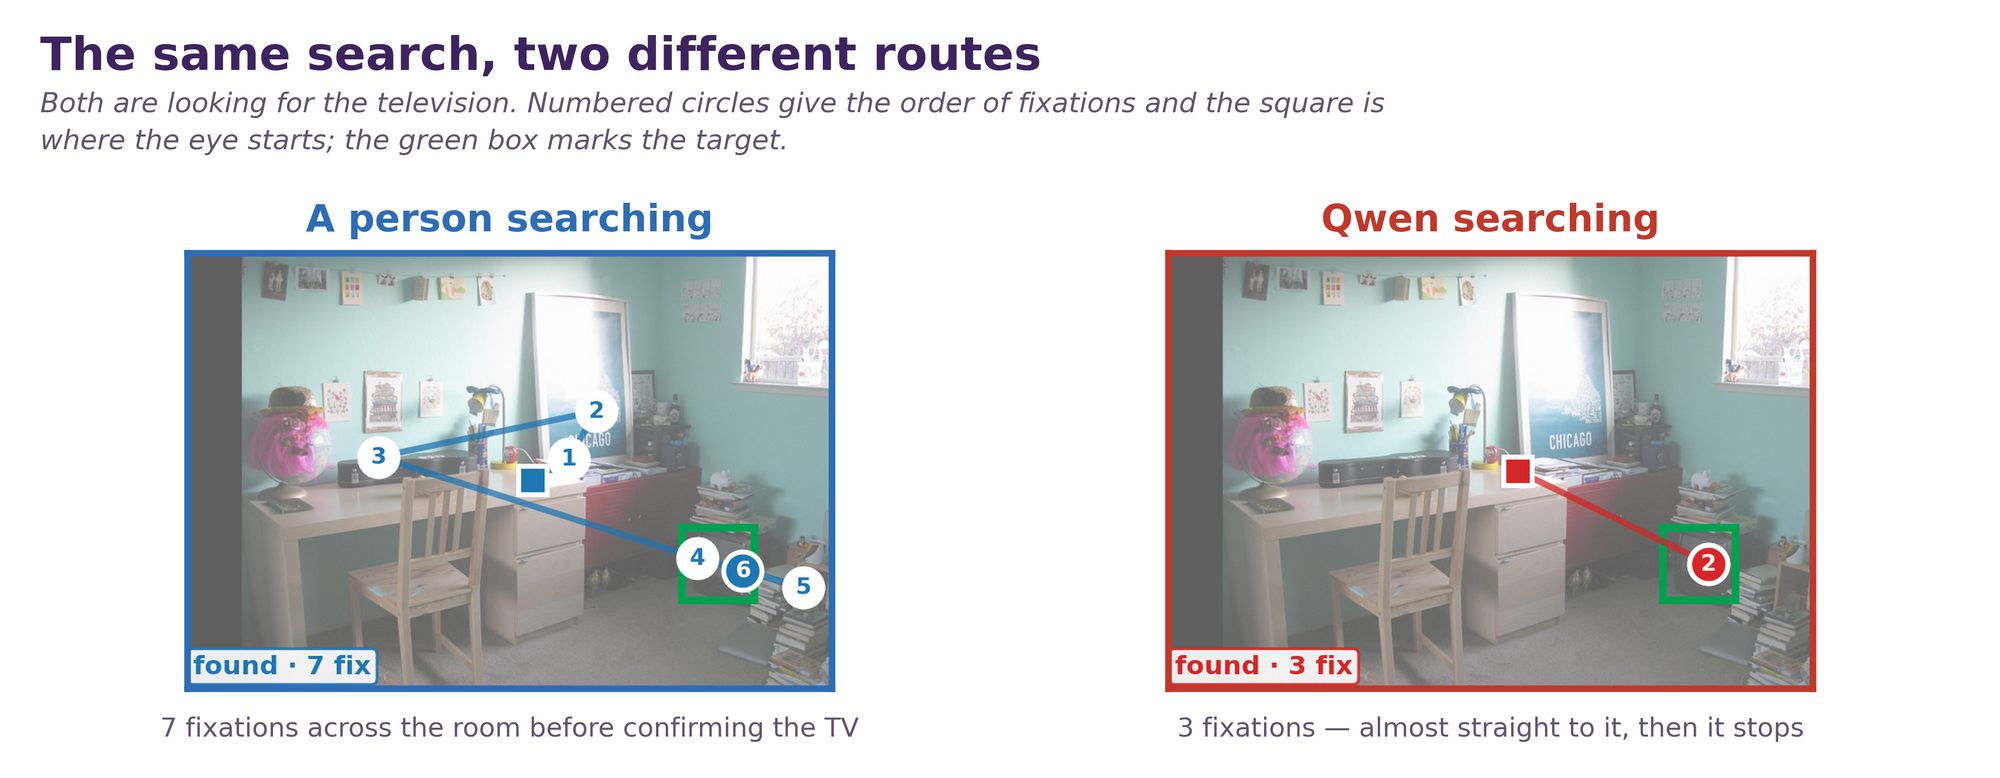
Fig. 1. Une même recherche, deux trajectoires différentes. À gauche : un humain cherchant la télévision effectue 7 fixations à travers la pièce avant de confirmer sa présence. À droite : l’IA (Qwen, observant la scène à travers un œil humain simulé) se dirige presque immédiatement vers la cible et s’arrête après 3 fixations. Les chiffres indiquent l’ordre des fixations et le cadre vert marque la cible.
Demandez à des personnes de trouver un objet dans des photos comme celle-ci, et leur premier mouvement oculaire atteindra la cible environ une fois sur deux. Donnez la même tâche à un modèle d’IA multimodale observant l’image à travers un œil humain simulé, et il atteindra la cible presque systématiquement : 97 % du temps pour les meilleurs modèles.
Cela pourrait sembler être une victoire pour une vision artificielle similaire à celle de l’humain. Ce n’est pas le cas. Dans notre nouvel article, nous montrons que ces modèles parviennent à la bonne réponse en empruntant une trajectoire complètement différente. Ils obtiennent des résultats comparables à ceux des humains, mais leur processus de recherche ne ressemble en rien au nôtre. Cet écart est important, car les métriques généralement utilisées pour déterminer si une IA « voit comme nous » ne permettent pas de le détecter.
Pourquoi cela compte aujourd’hui
Les chercheurs utilisent de plus en plus les grands modèles de langage multimodaux, des systèmes d’IA capables de traiter à la fois des images et du texte, comme substituts à des observateurs humains. Une approche courante consiste à vérifier si un modèle donne les mêmes réponses que les humains, ou s’il porte son attention sur les mêmes zones d’une image. Si c’est le cas, on considère souvent que le modèle voit de la même manière que les humains.
Nous avons voulu tester cette hypothèse sur l’une des fonctions les plus fondamentales de la vision humaine : chercher quelque chose.
Donner un œil humain à une IA
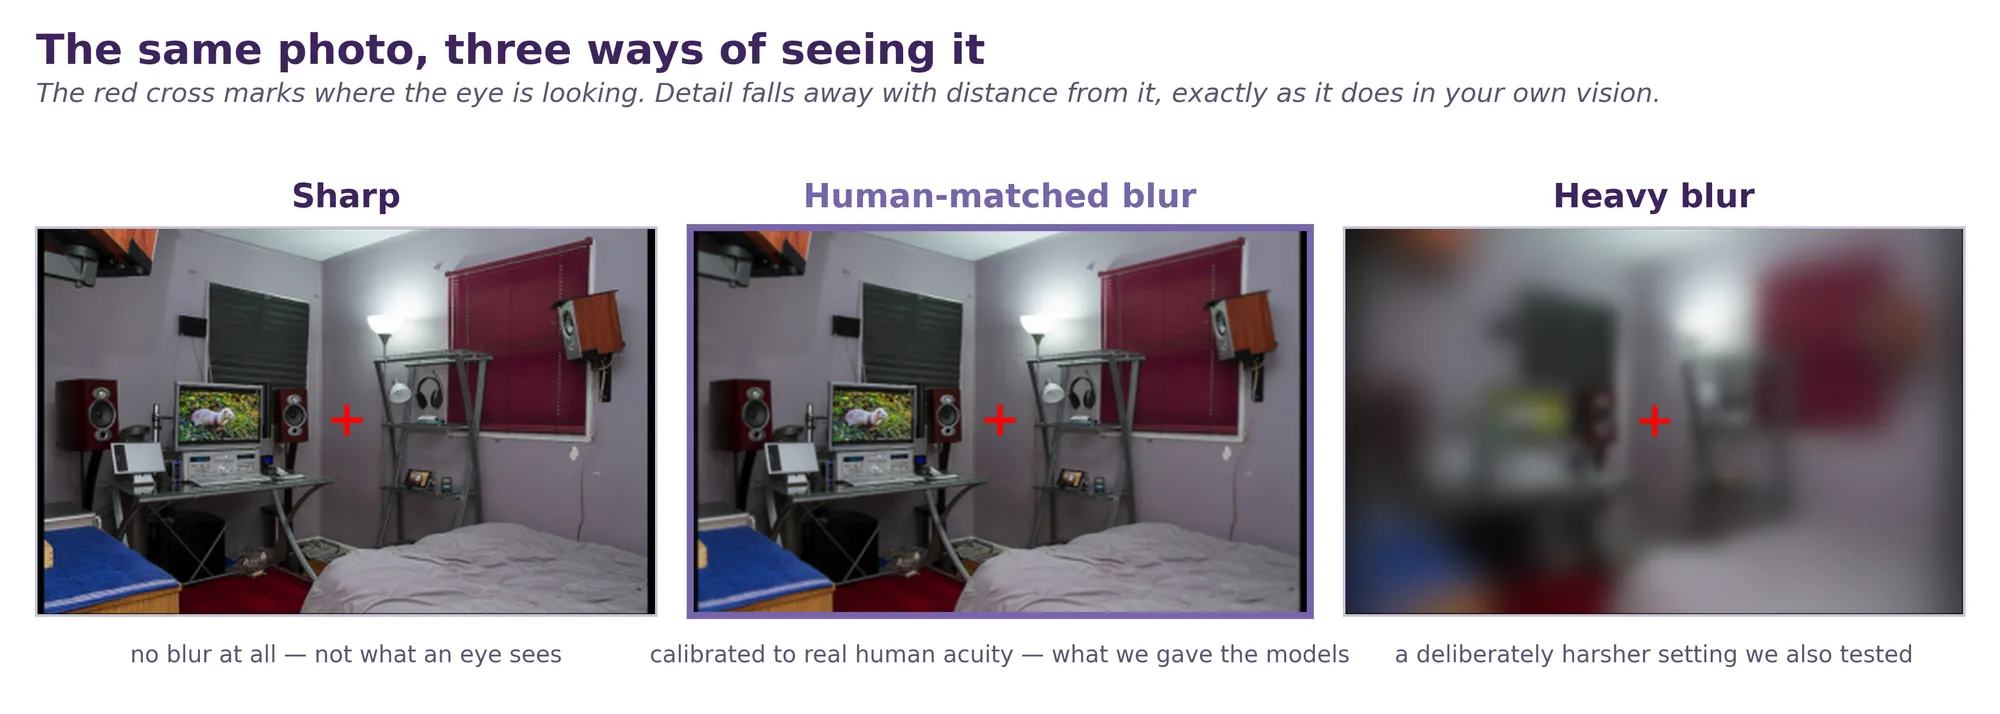
Fig. 2. Trois versions d’une même photographie de chambre. La première est nette, la deuxième est presque identique mais présente un léger flou vers les bords, et la troisième est fortement floutée à l’exception de la zone située autour d’une petite croix rouge au centre.
Les yeux humains ne voient nettement que dans une toute petite zone située au centre du regard. Tout le reste est flou. Pour trouver quelque chose, il faut déplacer ses yeux, vérifier, puis les déplacer à nouveau. La trajectoire constituée par ces différents points d’arrêt est appelée un scanpath, ou trajectoire oculaire.
Nous avons reproduit ce mécanisme pour trois modèles d’IA appartenant à différentes familles : Qwen, GLM et Gemma. Chaque modèle contrôlait un unique œil virtuel. À chaque étape, il voyait la photographie de manière nette à l’endroit où son regard était dirigé et de manière floue ailleurs, avec un niveau de flou calibré à partir de la vision humaine réelle. Il devait ensuite choisir entre trois actions :
- regarder ailleurs ;
- déclarer « trouvé » ;
- déclarer « ce n’est pas ici ».
Nous avons réalisé plus de 38 000 recherches de ce type à partir de photographies issues de COCO-Search18, un jeu de données dans lequel dix personnes réelles avaient recherché des objets dans chaque scène tandis que leurs mouvements oculaires étaient enregistrés. Cela nous a fourni une comparaison humaine directe pour chaque essai.
Mêmes réponses, recherche différente
En termes de résultats, les modèles étaient aussi performants que les humains, voire meilleurs. Ils déterminaient correctement si la cible était présente, la trouvaient au moins aussi souvent que les humains et n’avaient pas besoin de davantage de mouvements oculaires pour y parvenir.
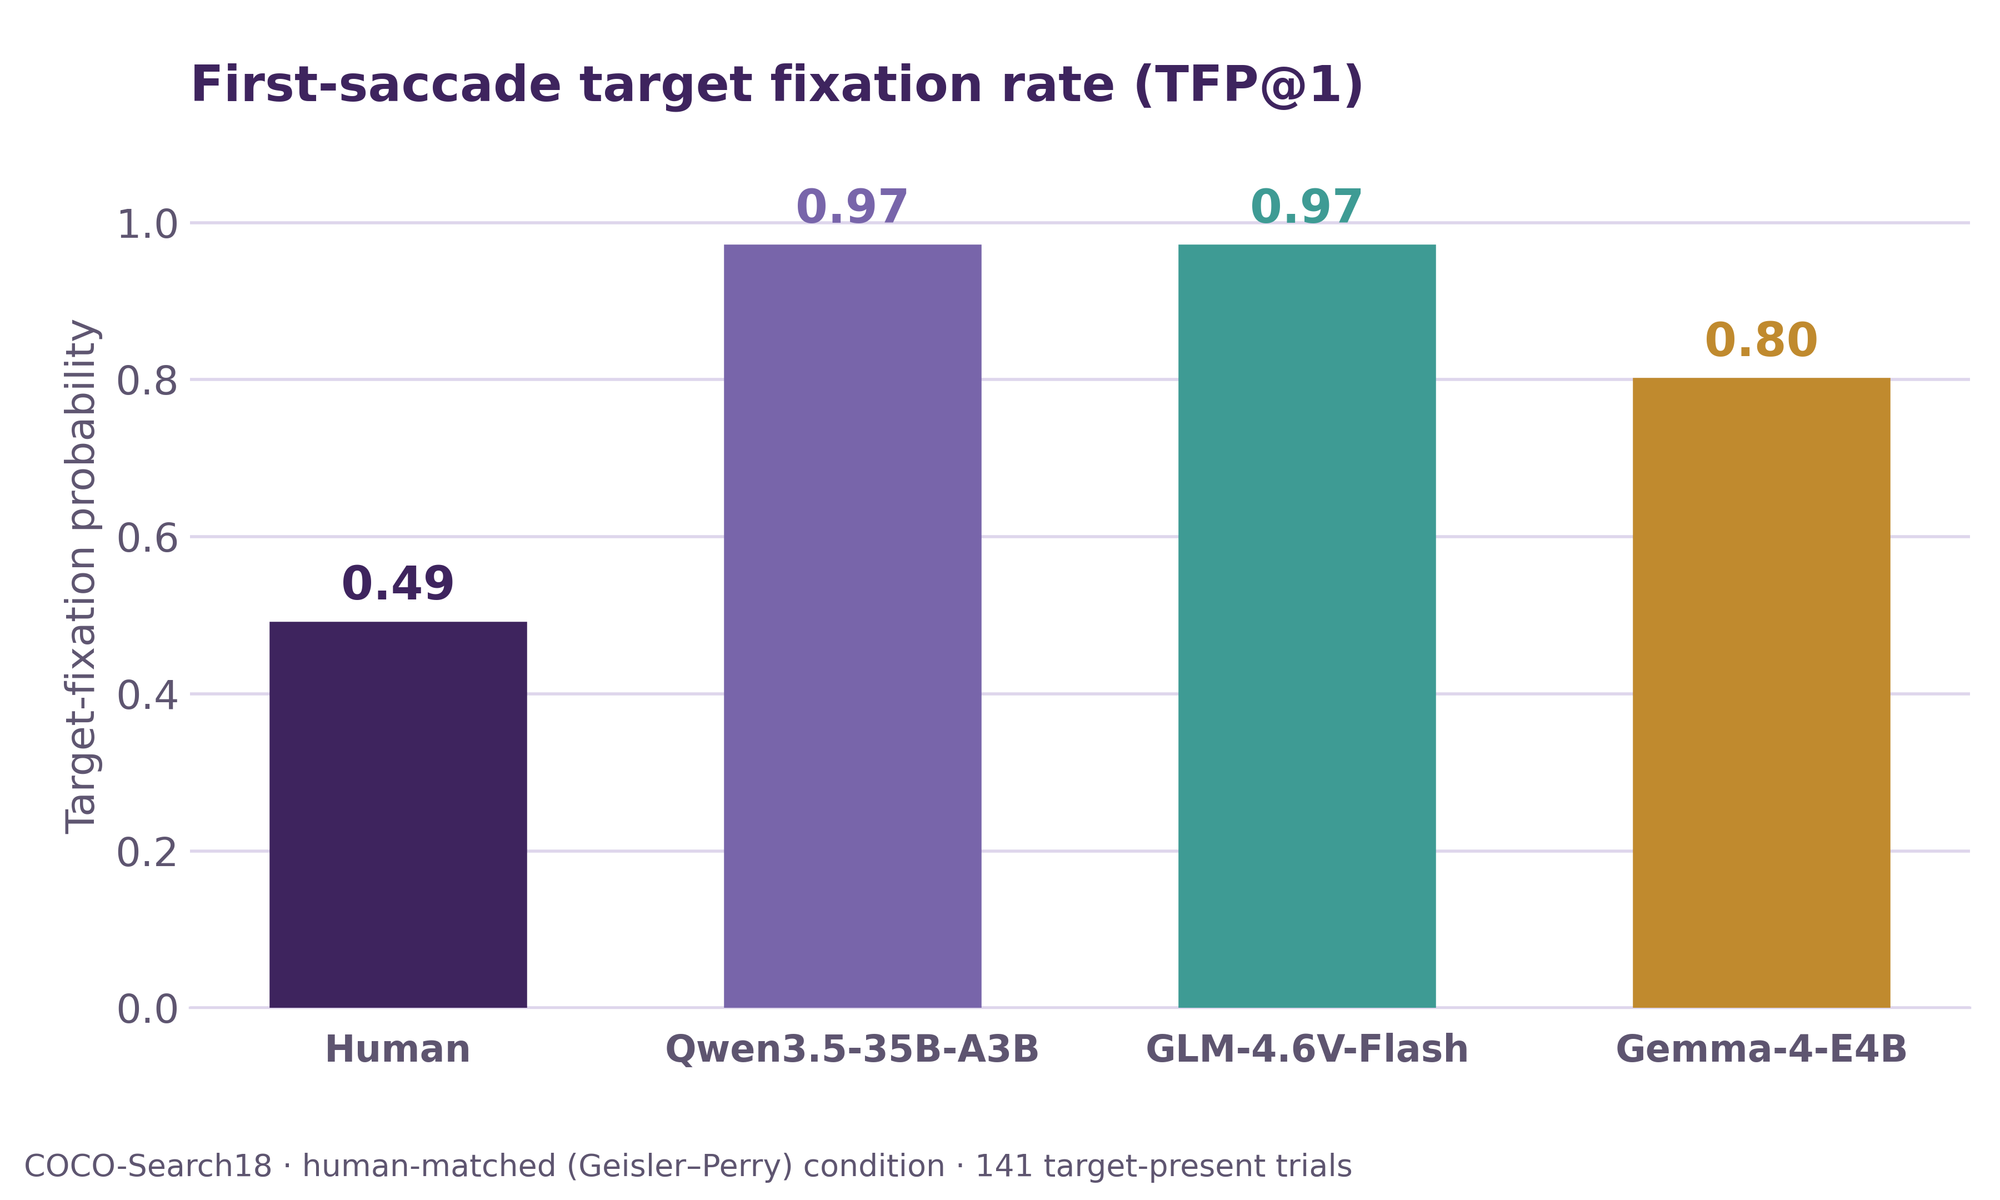
Fig. 3. Fréquence à laquelle le premier mouvement oculaire atteint la cible. Chez les humains, cela se produit environ une fois sur deux (49 %). Les trois modèles d’IA obtiennent des résultats nettement supérieurs : 97 % pour Qwen et GLM, et 80 % pour Gemma. Les résultats sont calculés sur 141 scènes dans lesquelles la cible était présente.
Au niveau du processus, cependant, leur comportement n’était clairement pas humain. Les trois modèles se distinguaient des humains de trois manières similaires :
Ils effectuent un grand saut plutôt que d’explorer. Les humains répartissent leur regard sur différentes zones d’une scène, tandis que les modèles se dirigent directement vers la cible avant de s’arrêter.
Ils explorent une portion très limitée de l’image. Leur regard reste concentré sur quelques zones seulement au lieu d’échantillonner l’ensemble de la scène.
Ils se répètent presque à l’identique. Lorsqu’un même modèle recherche plusieurs fois un objet dans une même photographie, il suit presque exactement la même trajectoire à chaque fois. Deux personnes différentes recherchant un objet dans une même photographie présentent beaucoup moins de similitudes entre leurs trajectoires qu’un modèle comparé à lui-même. Ce résultat persistait même lorsque nous augmentions volontairement le caractère aléatoire du comportement des modèles.
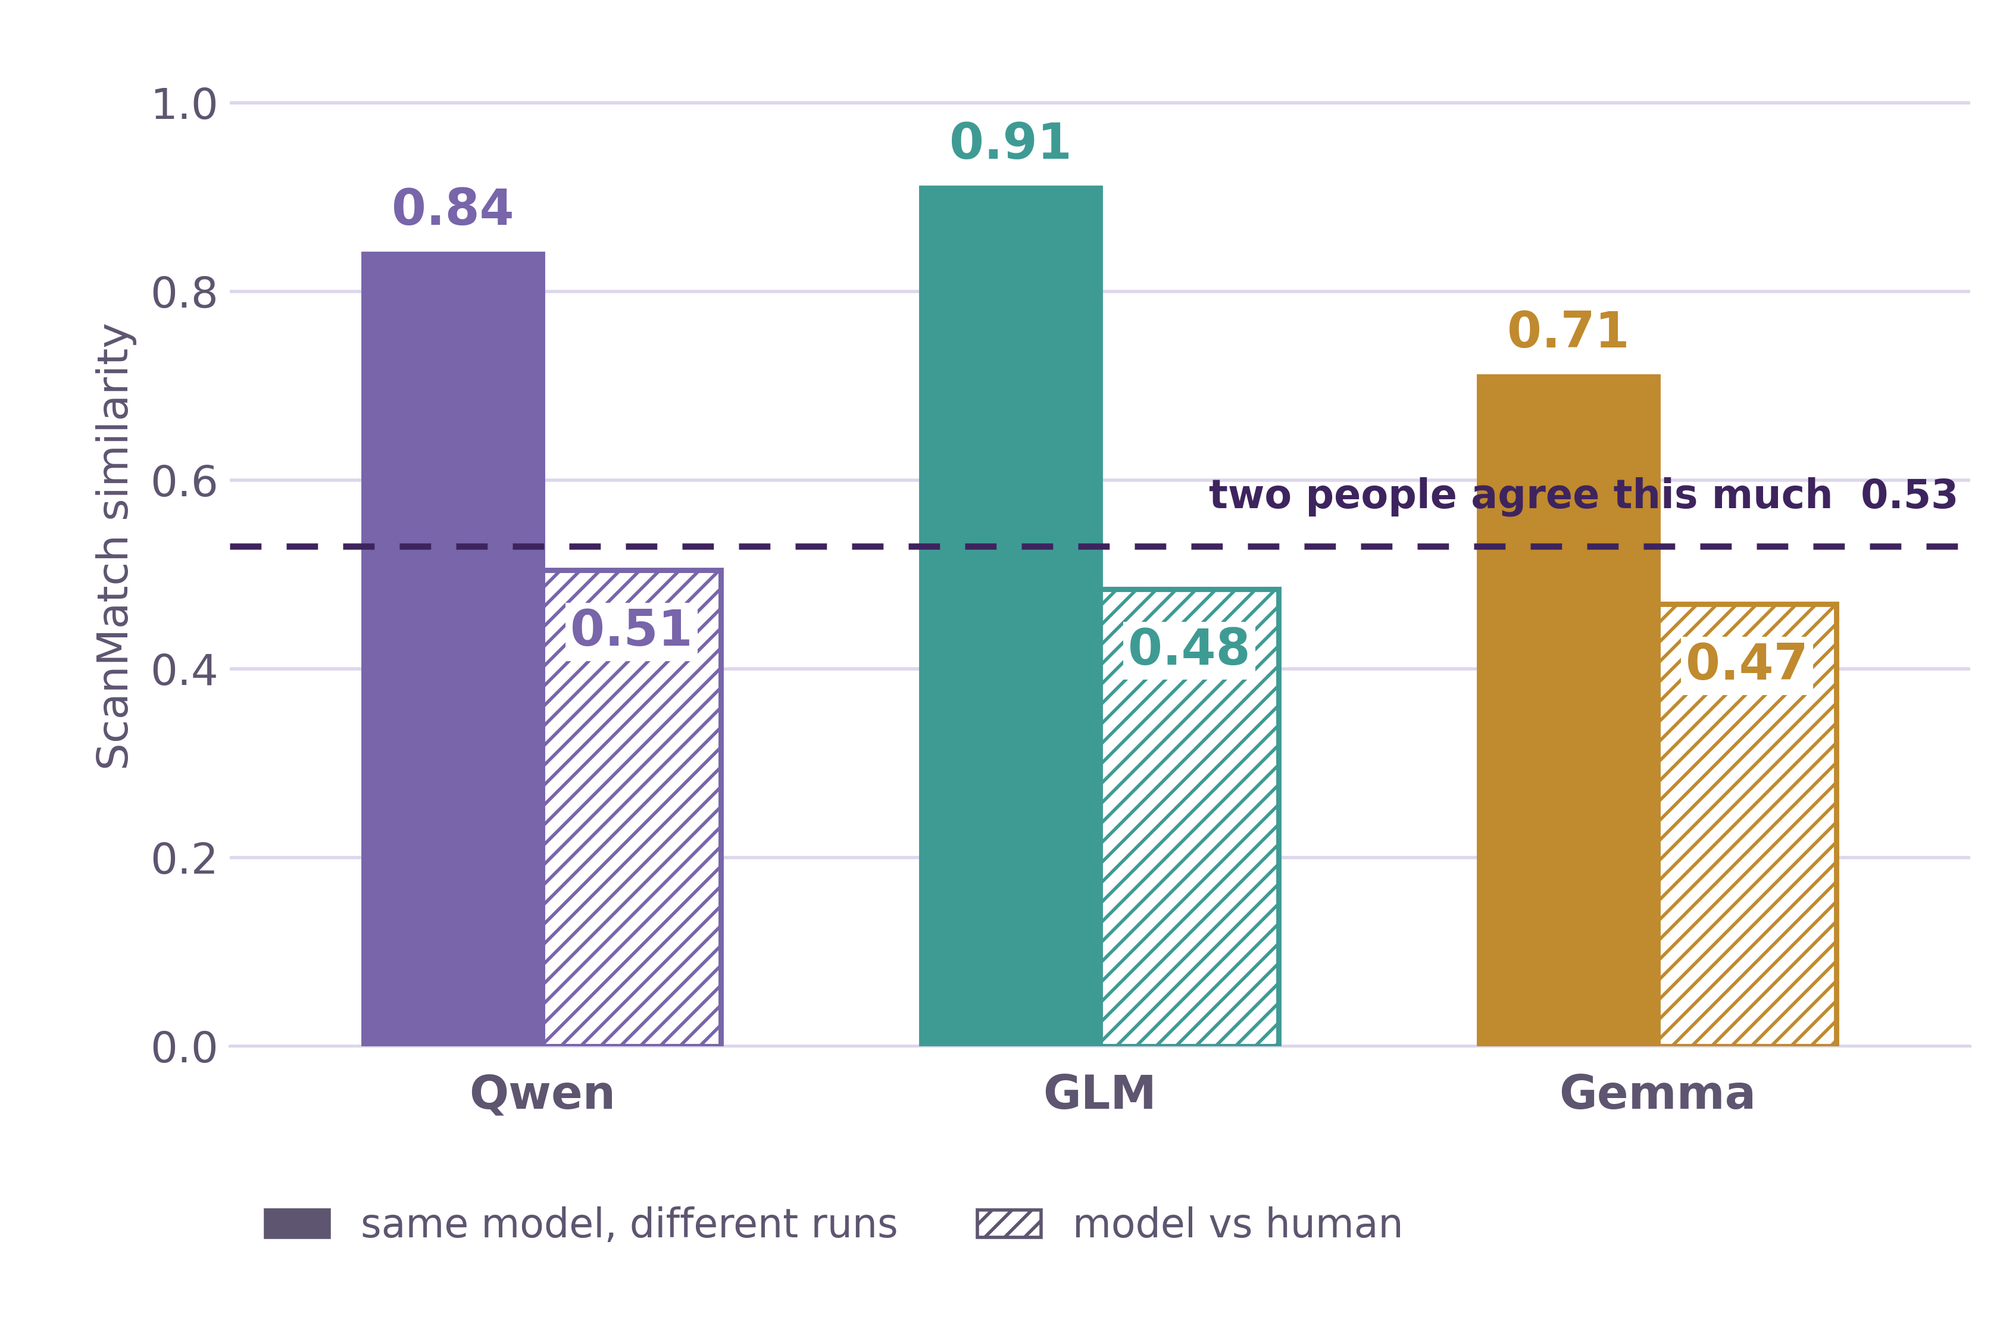
Fig. 4. Chaque modèle se répète davantage que deux personnes ne se ressemblent entre elles.
Rendre la vision plus floue ne résout pas le problème
Une objection naturelle consiste à penser que notre œil simulé n’était pas suffisamment flou et que les modèles pouvaient donc simplement voir trop d’informations. Nous avons testé cette hypothèse directement.
Premièrement, l’application d’un flou calibré sur la vision humaine n’a pratiquement eu aucun effet sur les modèles. Ils se comportaient de la même manière avec ce flou qu’avec une image parfaitement nette.
Deuxièmement, nous avons progressivement renforcé le niveau de flou. Les modèles n’ont jamais commencé à chercher comme les humains. Leur précision au premier regard et leur taux de réussite global diminuaient simultanément. Ainsi, lorsque leur précision au premier regard atteignait un niveau comparable à celui des humains, les modèles commençaient à manquer des cibles que les humains trouvaient normalement sans difficulté. Lorsque leurs trajectoires visuelles commençaient finalement à ressembler davantage aux nôtres, c’était parce qu’ils étaient en train d’échouer : ils revenaient sur des zones qu’ils n’avaient pas réussi à distinguer, puis abandonnaient en déclarant que la cible n’était pas présente.
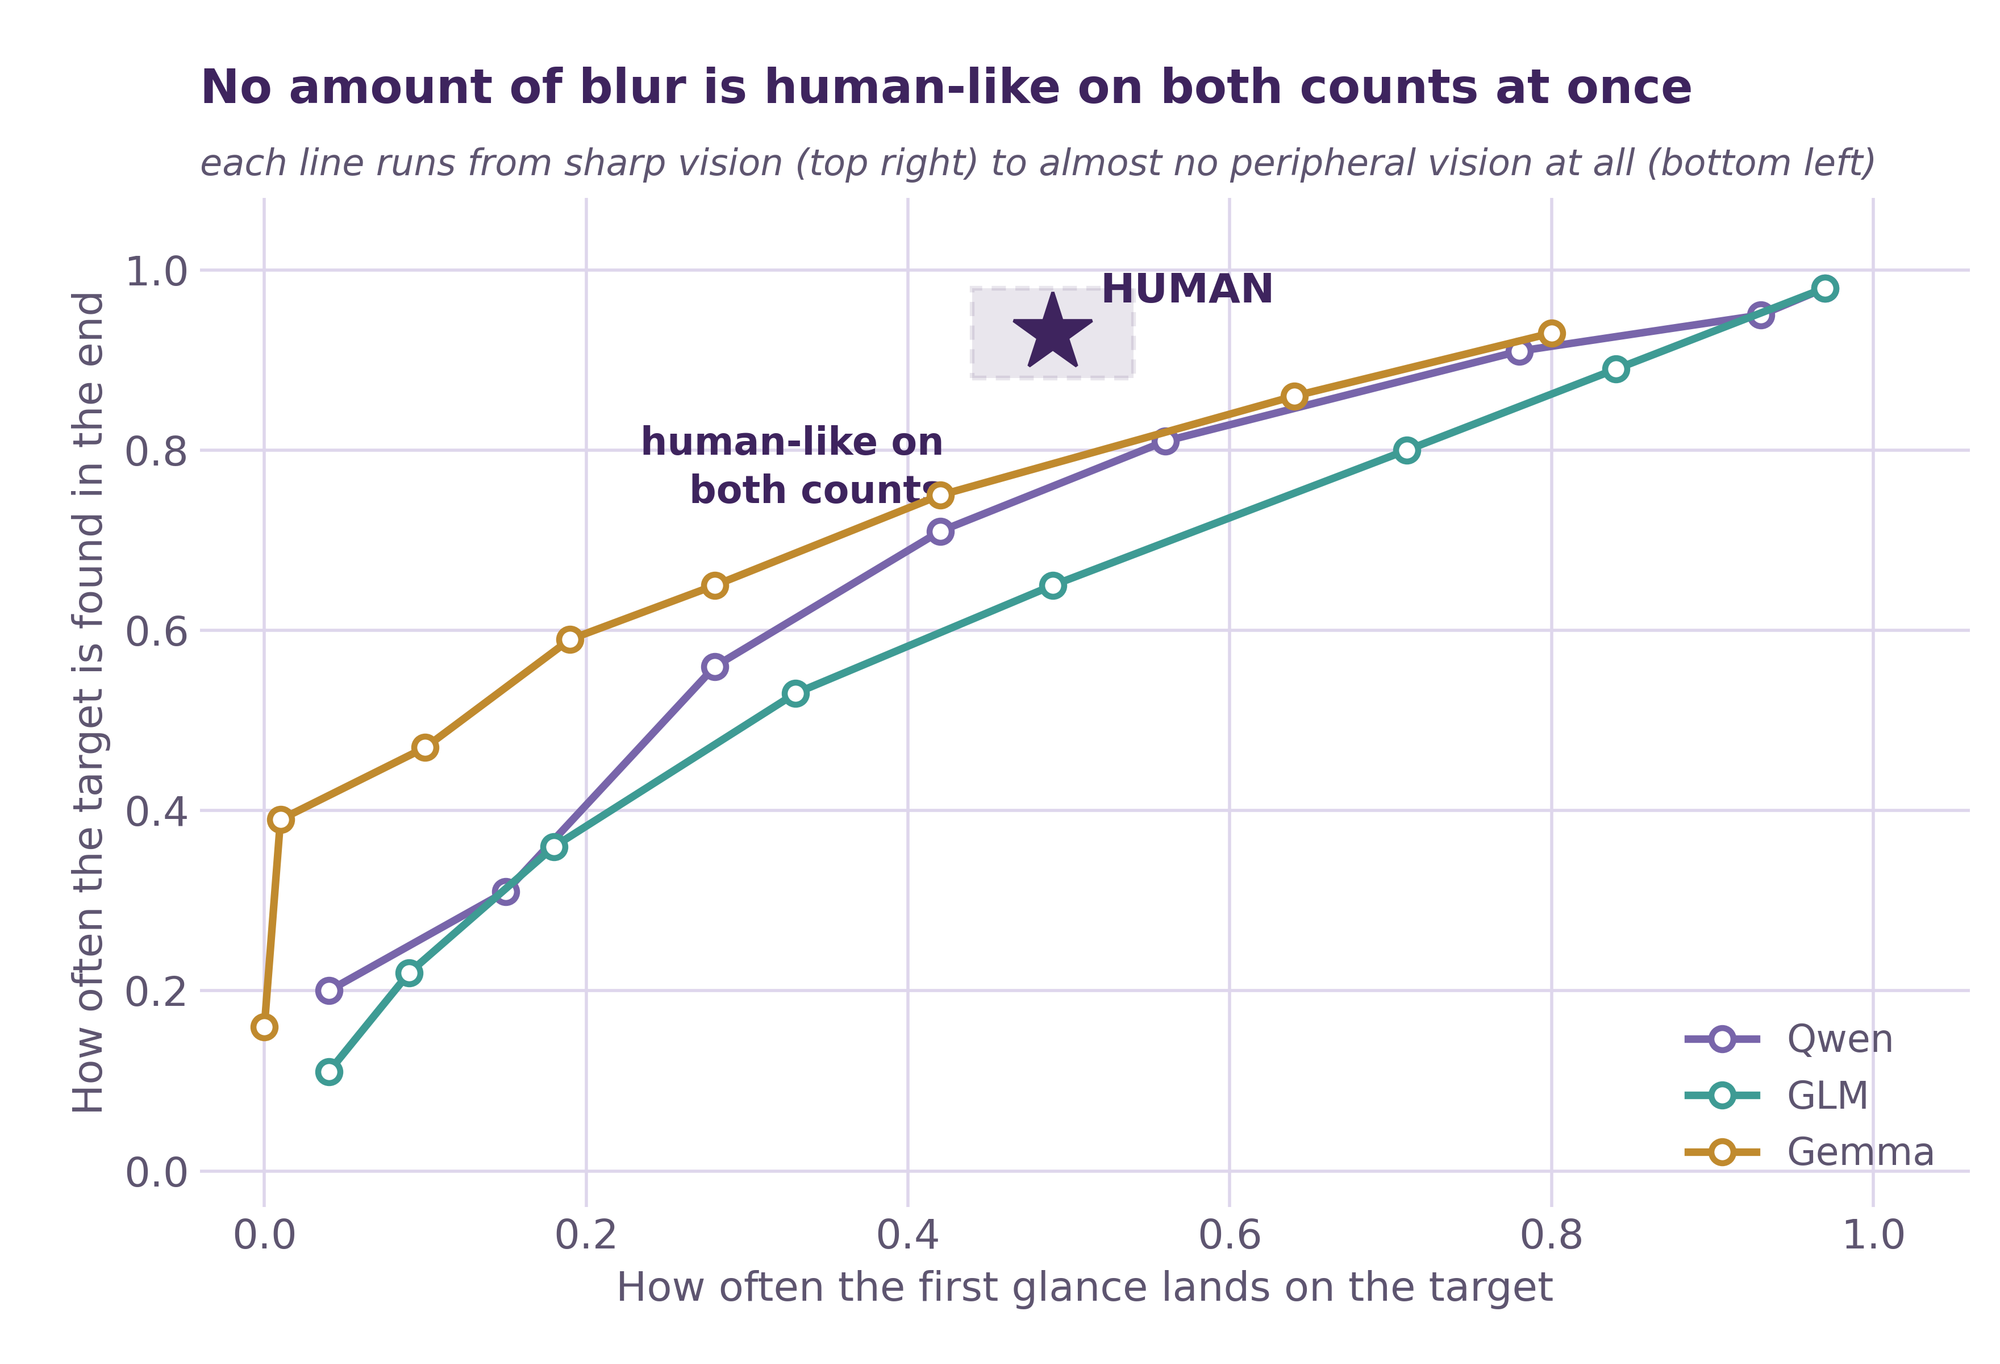
Fig. 5. Aucun niveau de flou ne permet aux modèles de rechercher comme les humains.
Fait intéressant, les modèles regardent néanmoins approximativement les mêmes zones que les humains. Les cartes représentant les zones observées par les modèles présentent un chevauchement raisonnable avec celles des humains. Ce qu’ils ne reproduisent pas, c’est la manière dont l’observation se déroule dans le temps.
Notre meilleure explication est que ces modèles traitent l’ensemble d’une image en une seule fois, tandis que la vision humaine doit progresser regard après regard. Nous n’avons toutefois pas modifié l’architecture des modèles afin de tester directement cette hypothèse de manière causale. Cette étape devra donc faire l’objet de futurs travaux.
Ce qu’il faut retenir
Obtenir la bonne réponse n’est pas la même chose que voir comme un humain. Si l’on mesure uniquement les réponses finales, ou uniquement les zones d’une image sur lesquelles un modèle porte son attention, les modèles d’IA peuvent sembler très proches des humains alors même que le processus sous-jacent est complètement différent.
Deux enseignements pratiques se dégagent de ces résultats :
- Les modèles d’IA constituent de bons substituts lorsqu’il s’agit d’étudier les résultats. Ils peuvent aider à déterminer ce que les humains sont susceptibles de remarquer, approximativement où ils regarderont et s’ils considéreront qu’une cible est présente.
- Ils constituent de mauvais substituts lorsqu’il s’agit d’étudier le processus. Ils ne permettent pas de déterminer comment les humains déplacent leurs yeux, combien de temps ils cherchent ou à quel moment ils décident d’arrêter leur recherche.
Il existe également un aspect positif. Un système capable d’obtenir des résultats de niveau humain sans procéder regard après regard constitue un point de comparaison particulièrement utile. La comparaison entre ce système et la recherche visuelle humaine peut nous aider à identifier les aspects de notre comportement qui existent précisément parce que nous sommes contraints d’observer une zone à la fois.
Si vous travaillez sur l’évaluation de l’IA ou sur la vision humaine, la leçon est simple : lorsque vous cherchez à savoir si un modèle « voit comme nous », assurez-vous de mesurer comment il regarde, et pas uniquement ce qu’il conclut.
Lire l’article complet sur arXiv
Questions fréquentes
Quelle est la principale différence entre la vision de l’IA et la vision humaine ?
Les modèles d’IA peuvent obtenir des résultats similaires ou supérieurs à ceux des humains lors de tâches de recherche de cibles visuelles, mais leur processus de recherche est différent. Les humains déplacent leurs yeux à travers une scène à l’aide de plusieurs fixations, tandis que les modèles d’IA testés se dirigent souvent directement vers la cible.
Les modèles d’IA peuvent-ils rechercher des objets dans une image comme les humains ?
Pas nécessairement. Cette étude montre que les modèles d’IA multimodale peuvent produire des résultats comparables à ceux des humains sans reproduire le processus humain de recherche visuelle. Leurs trajectoires du regard, leur manière d’explorer les images et leur niveau de répétition diffèrent considérablement.
Quelle est la précision des modèles d’IA pour trouver des cibles visuelles ?
Dans cette étude, le premier mouvement oculaire atteignait la cible dans 97 % des scènes contenant une cible pour Qwen et GLM, et dans 80 % des cas pour Gemma, contre 49 % chez les humains. Ces résultats concernent uniquement les modèles et les scènes testés dans cette étude et ne s’appliquent pas à toutes les tâches de recherche visuelle réalisées par des IA.
Qu’est-ce que la recherche visuelle en IA ?
La recherche visuelle consiste à localiser un objet ou une cible spécifique à l’intérieur d’une image. Dans cette étude, les modèles d’IA réalisaient cette tâche à travers un œil humain simulé.
Qu’est-ce qu’un scanpath ?
Un scanpath est la séquence de fixations du regard effectuées lors de l’exploration d’une scène.
Qu’est-ce que l’IA multimodale ?
Une IA multimodale traite plusieurs types de données, par exemple des images et du texte. Cette étude a testé des modèles appartenant aux familles Qwen, GLM et Gemma.
Rendre la vision de l’IA plus floue permet-il de rendre sa recherche plus similaire à celle des humains ?
Non. L’augmentation du flou simulé réduisait les performances de recherche des modèles mais ne permettait pas de reproduire le processus de recherche humain.
Pourquoi est-ce important si l’IA obtient malgré tout la bonne réponse ?
Le fait d’obtenir la même réponse finale ne signifie pas que le processus sous-jacent est identique. Les modèles pouvaient localiser correctement les cibles tout en suivant des trajectoires du regard différentes de celles des humains.
Peut-on utiliser des modèles d’IA comme substituts à des observateurs humains ?
Les résultats suggèrent que ces modèles peuvent être utilisés pour certaines questions portant sur les résultats, par exemple pour déterminer si une cible sera remarquée. En revanche, ils doivent être utilisés avec prudence pour déduire la séquence et la temporalité des mouvements oculaires humains.
Quels modèles d’IA ont été testés ?
L’étude a testé trois familles de modèles : Qwen, GLM et Gemma.
Combien de recherches visuelles ont été analysées ?
Les chercheurs ont réalisé plus de 38 000 recherches effectuées par l’IA sur des images issues de COCO-Search18 et les ont comparées à des mouvements oculaires humains enregistrés.
Que nous apprend cette étude sur les IA dites « human-like » ?
Des résultats similaires ne signifient pas nécessairement que les processus sont similaires. Pour déterminer si la vision d’une IA ressemble à la vision humaine, il est nécessaire de mesurer comment le modèle effectue sa recherche, et pas uniquement le résultat auquel il parvient.